
こんな悩みはありませんか?
- 同じ顧客が2つのIDで登録されている
- データを1件修正したら、あちこちで矛盾が起きた
- 顧客情報と購入履歴が同じ表に混在していて、誰が何を買ったか把握しにくい
これらはすべて、データベースが正規化されていないことで起きる典型的なトラブルです。データベースの正規化とは、データの重複や矛盾を排除するために、テーブル構造を段階的に整理していく設計手法のことです。1970年にE.F.コッドが発表した関係モデルの論文が理論の起点となり(A Relational Model of Data for Large Shared Data Banks)、現在もリレーショナルデータベース設計の基本として使われています(What is database normalization?)。
この記事では、正規化の意味と第1〜第3正規形(1NF・2NF・3NF)の違いを、具体例とともに解説します。あわせて、実際の手順やメリット・デメリット、分析基盤や機械学習の文脈における「正規化」との違いも紹介します。
- 正規化とは:データの重複や矛盾を排除するためにテーブル構造を段階的に整理する設計手法
- 1NF・2NF・3NFの違い:1NFは各列がスカラ値になっている状態、2NFは非キー属性が主キーに完全従属している状態、3NFは非キー属性が他の非キー属性に推移従属していない状態
- メリット・デメリット:JOIN増加によるクエリの複雑化というデメリットを解消する手段が「反正規化(非正規化)」
- 実務での使い分け:OLTP(業務システム)は正規化、BigQueryなどの分析基盤は非正規化が基本
- 機械学習との違い:データベース正規化と機械学習の「正規化(特徴量スケーリング)」はまったく別の概念
データベースの正規化とは?
データベースの正規化とは、データの重複や矛盾を排除するために、テーブル構造を段階的に整理していくプロセスのことです。テーブルを分割し、主キー(各行を一意に識別する列)と外部キー(他のテーブルの主キーを参照する列)で関連付けることで、同じ情報を複数箇所で管理する必要がなくなります。
正規化の目的は?
正規化の目的は、大きく分けて3つあります。
- データの整合性:同じ情報が複数箇所に重複して存在しないため、1回の修正で全体を正確に保てます。
- 更新時異常の防止:同じ事実を複数箇所で管理する必要を減らし、更新・追加・削除による矛盾を防ぎます。
- データの保守しやすさ:テーブル構造が明確になることで、将来の修正・拡張が容易になります。
正規化の具体例は?
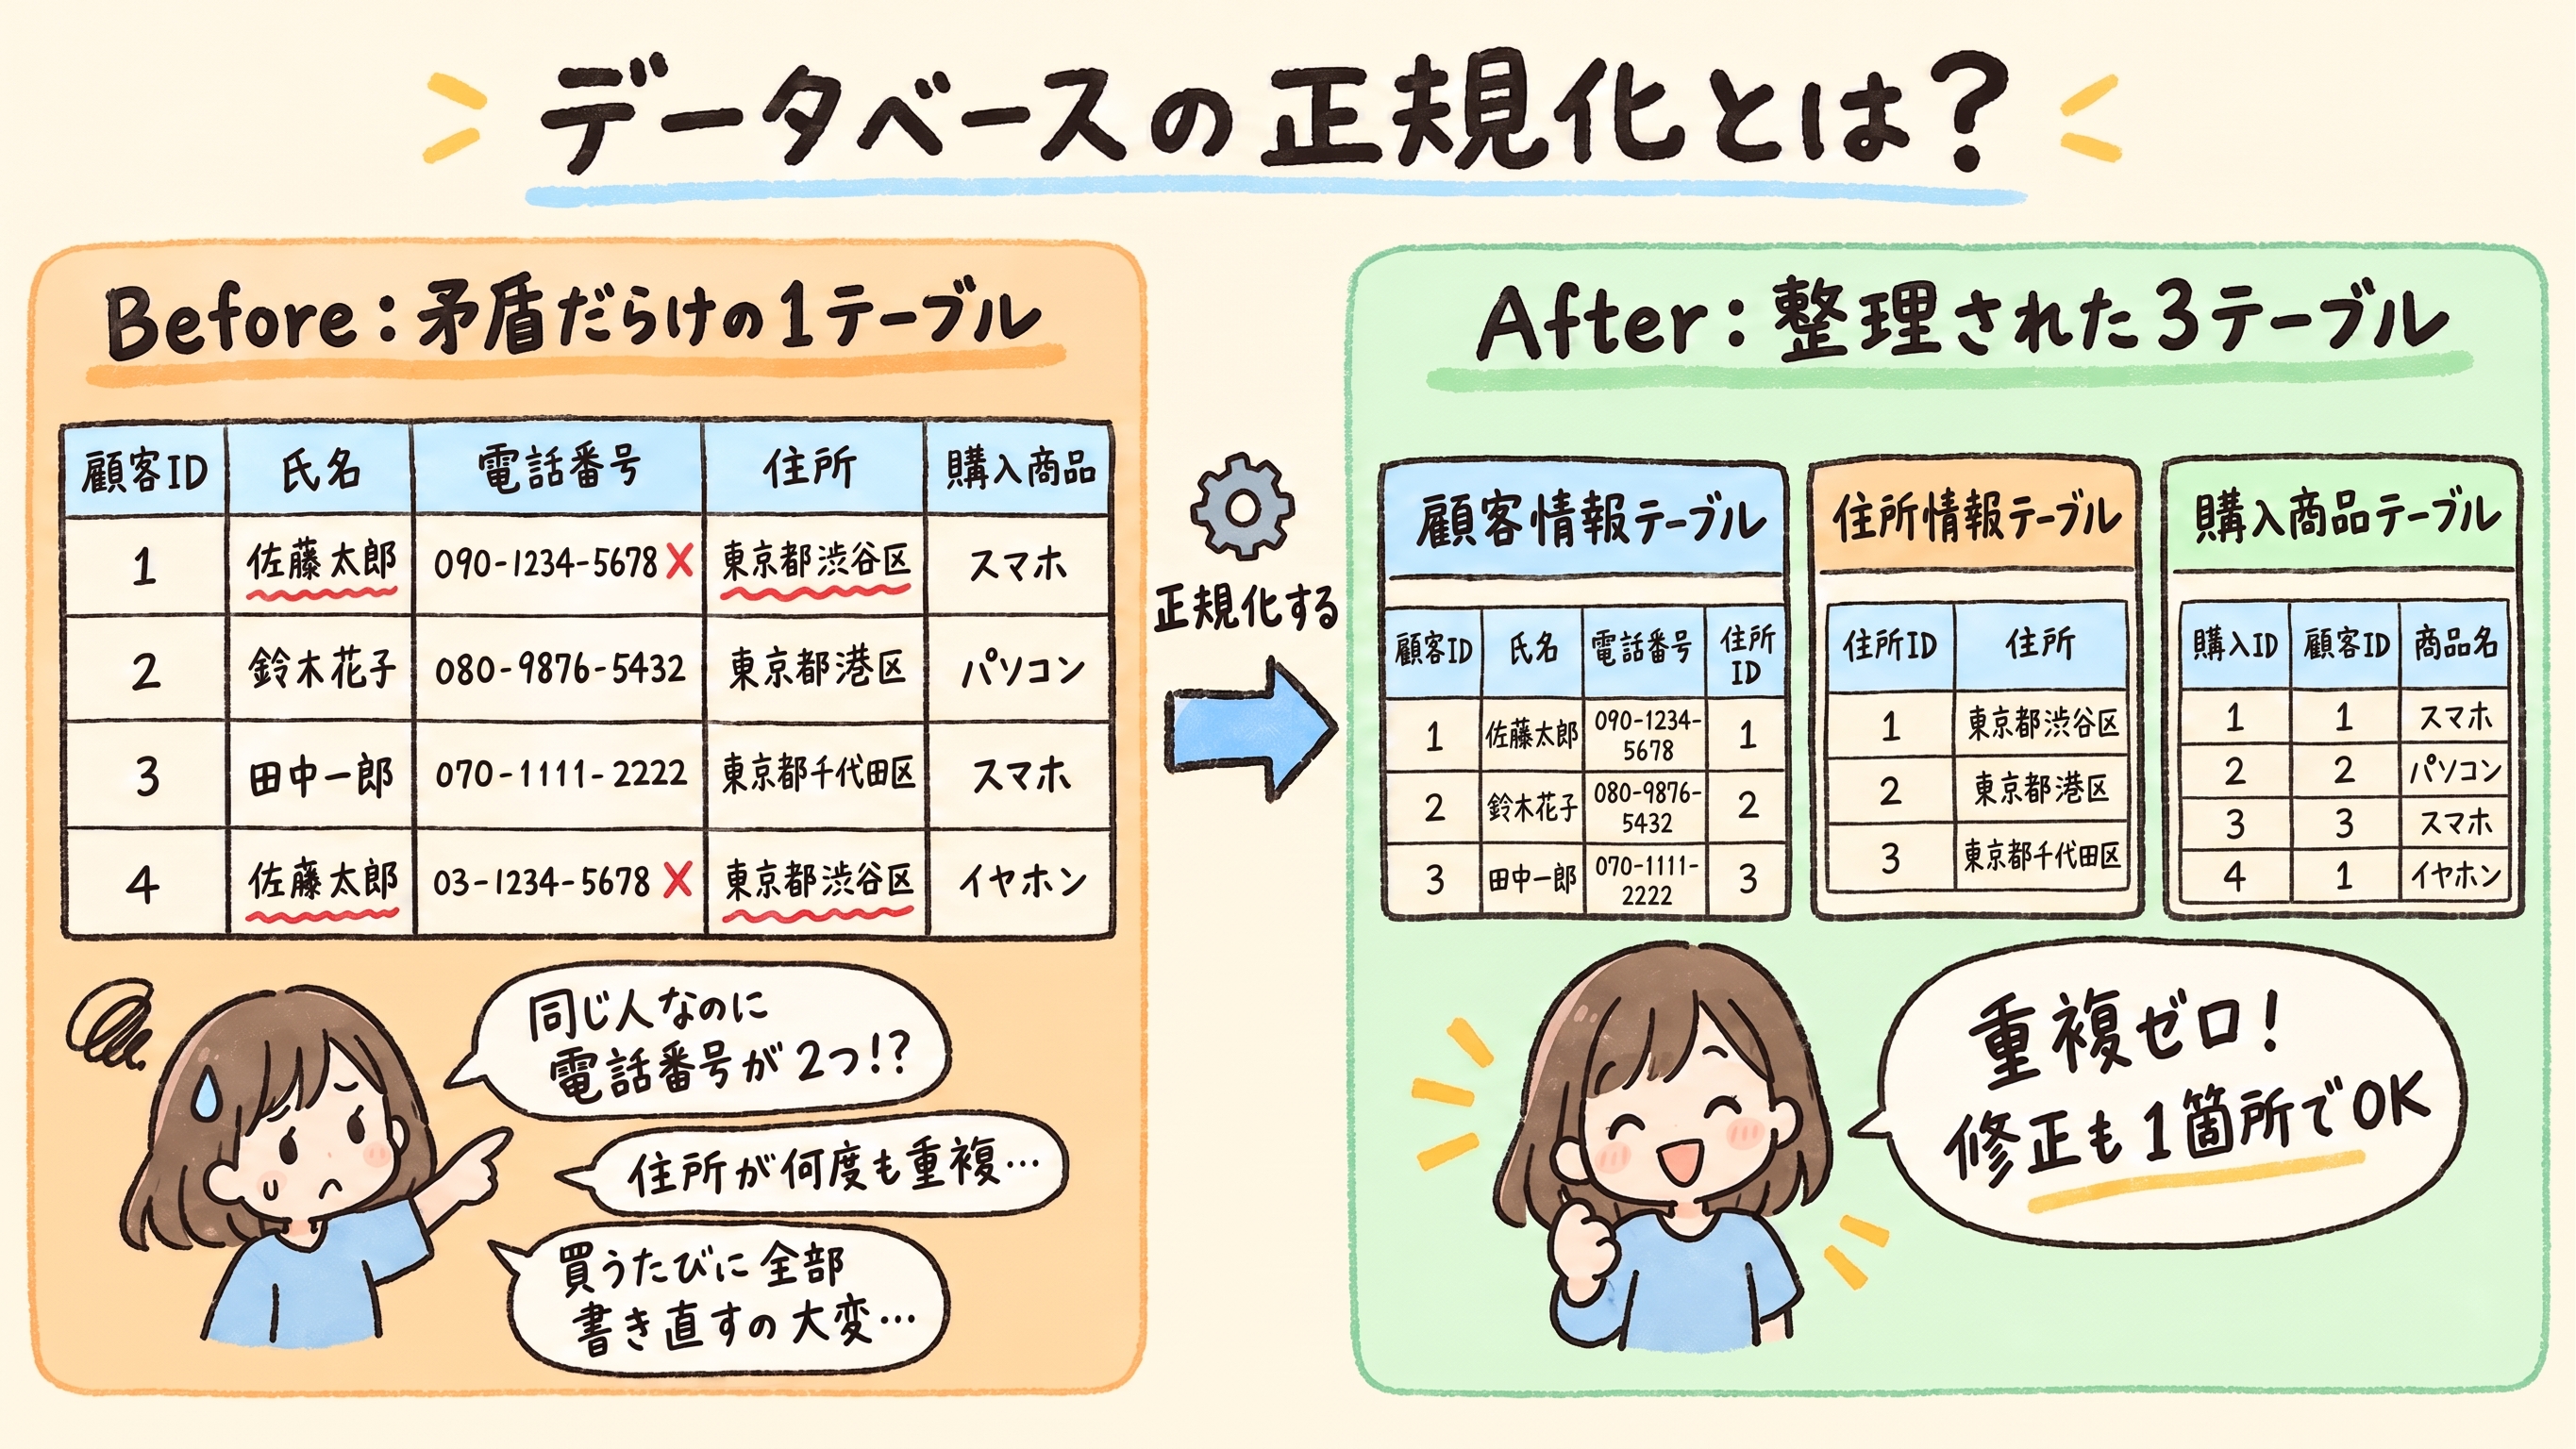
正規化を行うと、1つの巨大なテーブルを、重複のない複数のテーブルに分割できます。以下のような顧客情報テーブルがあったとします。
| 顧客ID | 氏名 | 電話番号 | 住所 | 購入商品 |
|---|---|---|---|---|
| 1 | 佐藤太郎 | 090-1234-5678 | 東京都渋谷区 | スマホ |
| 2 | 鈴木花子 | 080-9876-5432 | 東京都港区 | パソコン |
| 3 | 田中一郎 | 070-1111-2222 | 東京都千代田区 | スマホ |
| 4 | 佐藤太郎 | 03-1234-5678 | 東京都渋谷区 | イヤホン |
このテーブルには3つの問題があります。
- 顧客情報と購入情報が1つの表に混在している:佐藤太郎さんはスマホとイヤホンの2つを購入していますが、購入のたびに氏名・電話番号・住所を含む顧客の全情報を1行まるごと繰り返す必要があります。
- 繰り返しにより電話番号が食い違っている:顧客ID 1と4はどちらも佐藤太郎さんの行ですが、電話番号が異なります。同じ人のはずなのに、繰り返し入力するうちにどちらが正しいのか判断できなくなっています。
- 同じ理由で住所情報も食い違うリスクがある:住所「東京都渋谷区」も1行目と4行目に別々に入力されているため、引っ越しがあったときに片方だけ更新し忘れると情報が食い違ったままになります。
正規化を行うと、以下のように分割できます。顧客ID 1と4は同じ佐藤太郎さんなので、顧客情報は1つのレコード(顧客ID 1)にまとめます。もともと顧客ID 4に紐づいていたイヤホンの購入履歴も、統合後の顧客ID 1に結びつけます。
なお、どちらの電話番号が正しいかは正規化そのものでは判断できません。ここでは顧客への確認などにより090-1234-5678が現在の番号だと判明したとして統合しています。正規化が防いでくれるのは、レコードを1つにまとめることで今後は同じ人の電話番号が複数箇所に分かれて食い違う事態が起きなくなることです。
顧客情報テーブル
| 顧客ID | 氏名 | 電話番号 | 住所ID |
|---|---|---|---|
| 1 | 佐藤太郎 | 090-1234-5678 | 1 |
| 2 | 鈴木花子 | 080-9876-5432 | 2 |
| 3 | 田中一郎 | 070-1111-2222 | 3 |
住所情報テーブル
| 住所ID | 住所 |
|---|---|
| 1 | 東京都渋谷区 |
| 2 | 東京都港区 |
| 3 | 東京都千代田区 |
購入商品テーブル
| 購入ID | 顧客ID | 商品名 |
|---|---|---|
| 1 | 1 | スマホ |
| 2 | 2 | パソコン |
| 3 | 3 | スマホ |
| 4 | 1 | イヤホン |
テーブルを分割することで重複がなくなり、どのデータも一箇所で管理できるようになりました。
正規化の種類:第1〜第3正規形とBCNF以上は?
正規化は段階的に行うもので、「正規形」と呼ばれるレベルが定義されています。実務では第3正規形(3NF)までの適用が一般的で、4NF以上は複雑なデータモデルが必要な場面に限られます。
| 正規化の種類 | 説明 |
|---|---|
| 第1正規形(1NF) | 各列がスカラ値(それ以上分割できない値)である状態 |
| 第2正規形(2NF) | 1NFを満たし、非キー属性が主キーに完全従属している状態 |
| 第3正規形(3NF) | 2NFを満たし、非キー属性が他の非キー属性に推移従属していない状態 |
| ボイス・コッド正規形(BCNF) | 3NFを強化した形式。すべての関数従属(ある列の値が決まれば別の列の値が一意に決まる関係)の左辺がスーパーキー(1つ以上の属性の組み合わせで、各行を一意に識別できるもの)である状態 |
| 第4正規形(4NF) | BCNFを満たし、候補キーに基づかない多値従属がない状態 |
| 第5正規形(5NF) | 4NFを満たし、候補キーから暗示されない結合従属がない状態 |
- 主キー:表の中で各行を一意に特定できる列のことです。先ほどの顧客情報テーブルでは「顧客ID」が主キーにあたり、同じ顧客IDを持つ行が2つ存在することはありません。
- 非キー属性:主キー以外の列のことです。顧客情報テーブルでは「氏名」「電話番号」「住所ID」が非キー属性にあたり、これらの値は主キーである顧客IDが決まれば一意に定まります。
第1正規形(1NF)とは?
1NFとは、各列がスカラ値(それ以上分割できない値)である状態のことです。
例えば、1つのセルに「スマホ、パソコン」のように複数の値を入れると、1NFを満たしません。この場合は、商品ごとに行を分けるなどして、1つのセルには1つの値だけを持たせます。
なお、「東京都渋谷区〇〇丁目△△番地」のような住所文字列は、それを1つの値として扱う設計であれば、必ずしも1NF違反ではありません。
第2正規形(2NF)とは?
2NFとは、1NFを満たしたうえで、すべての非キー属性が主キーに完全従属している状態のことです。
例えば、以下のようなテーブルがあったとします。
| 顧客ID | 氏名 | 購入商品 |
|---|---|---|
| 1 | 佐藤太郎 | スマホ |
| 1 | 佐藤太郎 | パソコン |
このテーブルは1人の顧客が複数の商品を購入できるため、主キーは「顧客ID」と「購入商品」を組み合わせた複合キーになります。ここで「氏名」に注目すると、複合キーの一部である「顧客ID」だけで値が決まってしまい、「購入商品」には依存していません。これが部分従属で2NF違反です。
「購入ID」を新たに設けて、以下のように顧客テーブルと購入テーブルに分割することで2NFを満たせます。
顧客テーブル
| 顧客ID | 氏名 |
|---|---|
| 1 | 佐藤太郎 |
購入テーブル
| 購入ID | 顧客ID | 購入商品 |
|---|---|---|
| 1 | 1 | スマホ |
| 2 | 1 | パソコン |
顧客テーブルの主キーは「顧客ID」のみになったため、「氏名」は主キーに完全従属しています。
第3正規形(3NF)とは?
3NFとは、2NFを満たしたうえで、非キー属性が他の非キー属性に推移従属していない状態のことです。「Aが決まればBが決まり、BによってCが決まる」という連鎖依存があると推移従属にあたります。
例えば、以下のようなテーブルがあったとします。
| 顧客ID | 氏名 | 郵便番号 | 都道府県 |
|---|---|---|---|
| 1 | 佐藤太郎 | 150-0001 | 東京都 |
| 2 | 鈴木花子 | 108-0001 | 東京都 |
| 3 | 田中一郎 | 100-0001 | 東京都 |
「都道府県」は主キーの「顧客ID」ではなく、非キー属性の「郵便番号」によって決まります。郵便番号が決まれば都道府県が自動的に定まるため、「都道府県」は「郵便番号」に推移従属しています。この場合は、郵便番号と都道府県の対応を別テーブルで管理することで3NFを満たせます。
部分従属と推移従属の違いは、「主キーの一部だけで決まる(2NF違反)」か「非キー属性経由で決まる(3NF違反)」かという点です。2NF違反は主キーが複合キーの場合にのみ起こりうるのに対し、3NF違反は主キーが単一列でも起こる点に注意が必要です。
BCNF・第4正規形・第5正規形は必要?
3NFの先には、さらに厳密な正規形としてBCNF・第4正規形(4NF)・第5正規形(5NF)があります。それぞれ何を排除する正規形なのか、具体例で見ていきましょう。
ボイス・コッド正規形(BCNF)とは?
BCNFは、3NFをさらに厳しくした正規形で、非キー属性だけでなく、候補キー同士の従属関係も許しません。例えば、以下のような「学生・科目・講師」のテーブルがあったとします(1人の講師は1つの科目のみを担当し、1つの科目を複数の講師が担当できるものとします)。
| 学生ID | 科目 | 講師 |
|---|---|---|
| 1 | 数学 | 田中 |
| 2 | 数学 | 佐藤 |
| 1 | 英語 | 鈴木 |
このテーブルの主キーは「学生ID+科目」の複合キーです。「科目」はこの主キーの一部なので3NF違反にはなりませんが、「講師が決まれば科目が決まる」(田中→数学、鈴木→英語)という関数従属があり、その左辺「講師」は単独では行を一意に特定できるスーパーキー(1つ以上の属性の組み合わせで、各行を一意に識別できるもの)ではありません。これがBCNF違反です。
このテーブルは、以下のように「学生と講師の対応表」と「講師と科目の対応表」に分割することでBCNFを満たせます。
学生と講師の対応表
| 学生ID | 講師 |
|---|---|
| 1 | 田中 |
| 2 | 佐藤 |
| 1 | 鈴木 |
講師と科目の対応表
| 講師 | 科目 |
|---|---|
| 田中 | 数学 |
| 佐藤 | 数学 |
| 鈴木 | 英語 |
この2つの表を講師で結合すると、元の3行がそのまま復元できます。
第4正規形(4NF)とは?
4NFは、BCNFを満たしたうえで、候補キーに基づかない「多値従属」(1つのキーに対して、本来無関係な複数の値の組み合わせがすべて存在してしまう状態)を排除した正規形です。例えば、1人の社員が複数の「スキル」と複数の「趣味」を持てるとして、これを1つのテーブルにまとめると、以下のように本来無関係なスキルと趣味のすべての組み合わせを記録することになります。
| 社員 | スキル | 趣味 |
|---|---|---|
| 田中 | Excel | 読書 |
| 田中 | Excel | 登山 |
| 田中 | SQL | 読書 |
| 田中 | SQL | 登山 |
田中さんのスキルと趣味はそれぞれ2つずつなのに、組み合わせると4行に膨れ上がっています。これが多値従属による4NF違反です。以下のように「社員とスキルの対応表」「社員と趣味の対応表」の2つに分割することで4NFを満たせます。
社員とスキルの対応表
| 社員 | スキル |
|---|---|
| 田中 | Excel |
| 田中 | SQL |
社員と趣味の対応表
| 社員 | 趣味 |
|---|---|
| 田中 | 読書 |
| 田中 | 登山 |
第5正規形(5NF)とは?
5NFは、4NFを満たしたうえで、候補キーから暗示されない「結合従属」(3つ以上のテーブルに分割してから結合し直さないと、元の関係を過不足なく復元できない状態)が残っていない正規形です。「1つのテーブルのまま保持する必要がある」データとは具体的にどのようなものか、代理店・メーカー・製品の例で見てみましょう。以下のような事実があったとします。
| 代理店 | メーカー | 製品 |
|---|---|---|
| 代理店A | メーカーX | 製品1 |
| 代理店A | メーカーY | 製品2 |
| 代理店B | メーカーX | 製品2 |
つまり、代理店AはメーカーXから製品1を、メーカーYから製品2を仕入れており、代理店BはメーカーXから製品2を仕入れています。代理店AがメーカーXから製品2を仕入れている事実はありません。
このテーブルを「代理店とメーカー」「代理店と製品」「メーカーと製品」の3つの表に分割してみます。
| 代理店 | メーカー |
|---|---|
| 代理店A | メーカーX |
| 代理店A | メーカーY |
| 代理店B | メーカーX |
| 代理店 | 製品 |
|---|---|
| 代理店A | 製品1 |
| 代理店A | 製品2 |
| 代理店B | 製品2 |
| メーカー | 製品 |
|---|---|
| メーカーX | 製品1 |
| メーカーY | 製品2 |
| メーカーX | 製品2 |
この3つの表を結合し直すと、以下のようになります。
| 代理店 | メーカー | 製品 | 備考 |
|---|---|---|---|
| 代理店A | メーカーX | 製品1 | 元のテーブルにもある正しい組み合わせ |
| 代理店A | メーカーX | 製品2 | 実在しない組み合わせ |
| 代理店A | メーカーY | 製品2 | 元のテーブルにもある正しい組み合わせ |
| 代理店B | メーカーX | 製品2 | 元のテーブルにもある正しい組み合わせ |
代理店AがメーカーXと取引しており、かつ製品2も扱っているという事実だけから、実際には存在しない「代理店A・メーカーX・製品2」という組み合わせが復元されてしまいました。このように3つに分割すると事実と異なる組み合わせが生まれてしまう場合は分割できず、最初の1つのテーブルのまま保持する必要があります。分割してよいかどうかの判断は複雑なため、実務でこのレベルまで意識する場面は限られます。
BCNF・4NF・5NFまで明示的に検討する場面は、データモデルや要件によって限られます。
正規化の手順は?
実際にテーブルを正規化するときは、以下の順番で進めます。
Step 1:現状のテーブルを整理する 既存のテーブルやExcelシートを洗い出し、どの列(属性)があるかを把握します。
Step 2:1NFを適用する 各列にスカラ値のみが入るよう、繰り返し項目や複合値を分割します。
Step 3:2NFを適用する 主キーに部分従属している列がある場合、別テーブルに切り出します。
Step 4:3NFを適用する 非キー属性同士の推移従属がある場合、さらにテーブルを分割します。
Step 5:必要に応じてBCNF以上を検討する 複雑なデータ構造が必要な場合のみ、BCNFや4NF・5NFを検討します。多くのシステムでは3NFまでで十分です。
正規化のメリット・デメリットは?
正規化の最大のメリットは、データの重複と矛盾を防ぎ、更新・削除時の異常を回避できることです。
- データの一貫性を保てる:同じ情報が一箇所にしかないため、更新漏れや矛盾が起きません。
- 更新・削除の異常を防げる:非正規化テーブルで起きやすい「更新時に一部だけ変わる」「削除すると必要な情報まで消える」といった問題を回避できます。
- ストレージを節約できる:重複データがないためデータ量を抑えられます。
一方でデメリットもあります。正規化を進めるとテーブルが細かく分割されるため、データを取り出すときにJOINが増えてクエリが複雑になるという課題が生じます。テーブル結合が多くなるとパフォーマンスが低下し、大量データの集計が遅くなることもあります。
このトレードオフを解消するために使われるのが反正規化(非正規化・Denormalization)という手法です。意図的にデータを重複させることでテーブル結合の回数を抑え、クエリ応答速度を向上させる手法で、参照頻度が高いシステムで採用されます。非正規化による性能改善は、後述するBigQueryなどの分析基盤で具体的に採用されている考え方です。
先ほどの「顧客情報テーブル」「住所情報テーブル」(正規化された状態)を例に見てみましょう。顧客の住所を確認するには、この2つのテーブルをJOINする必要があります。
正規化された状態(JOINが必要)
顧客情報テーブル
| 顧客ID | 氏名 | 住所ID |
|---|---|---|
| 1 | 佐藤太郎 | 1 |
| 2 | 鈴木花子 | 2 |
住所情報テーブル
| 住所ID | 住所 |
|---|---|
| 1 | 東京都渋谷区 |
| 2 | 東京都港区 |
反正規化すると、JOINをせずに済むよう住所を顧客情報テーブルに直接持たせます。
反正規化した状態(JOIN不要)
| 顧客ID | 氏名 | 住所 |
|---|---|---|
| 1 | 佐藤太郎 | 東京都渋谷区 |
| 2 | 鈴木花子 | 東京都港区 |
住所を直接持たせることでJOINなしに住所を取得でき、クエリが速くなります。ただし、複数の顧客が同じ住所に住んでいる場合は住所情報が複数行に重複し、正規化前のテーブルが抱えていたのと同じ「引っ越しがあったとき複数行を修正しなければならない」という問題が再び生じます。反正規化は、この重複リスクを承知のうえで、クエリ性能を優先する選択です。
正規化と反正規化は「どちらが正しい」ではなく、用途に応じて使い分けるものなのです。次の章では、この使い分けが業務システムと分析基盤でどう変わるかを具体的に見ていきます。
正規化は実務でどう扱われている?
正規化は「常に適用すればよい」ものではなく、システムの用途によって最適解が変わります。ここではOLTP(業務システム)と分析基盤の違い、そして正規化の知識が今も求められている背景を見ていきます。
 OLTP(業務システム)では正規化、BigQueryなどの分析基盤では非正規化が推奨されるという使い分け(出典:Use nested and repeated fields)
OLTPと分析基盤(BigQuery等)で正規化の考え方はどう違う?
OLTP(業務システム)では正規化されたテーブル設計が基本ですが、BigQueryのような分析基盤ではあえて非正規化されたスキーマ(テーブル構造の設計)が推奨されます。
OLTPでは正規化が基本
日々の受発注や会員登録を処理するOLTP(Online Transaction Processing:オンライントランザクション処理)では、正規化された設計が基本です。更新・削除のたびにデータの矛盾が起きないようにするためです。
分析基盤(BigQuery等)では非正規化が推奨される
Google CloudのBigQuery公式ドキュメントは、ネスト・繰り返しフィールドを使った非正規化スキーマを積極的に推奨しています。JOINにはデータ間の通信・調整コストが伴うため、あらかじめデータを1つのテーブルにまとめておくことで並列実行がしやすくなり、クエリ性能が向上するためです(Use nested and repeated fields)。
さらにBigQueryへのデータウェアハウス移行に関する公式ガイドは、BigQueryのネイティブなスキーマ設計がスタースキーマ・スノーフレークスキーマ(正規化を前提としたデータウェアハウス設計モデル)のいずれでもなく、ネスト・繰り返しフィールドを前提としていると説明しています(データウェアハウスからBigQueryへの移行:スキーマとデータ転送の概要)。つまり、「正規化すればするほど良い」という考え方は、分析基盤には当てはまりません。
OLTPでは正規化、BigQueryのような分析基盤では用途に応じた非正規化、という使い分けが実務での基本方針です。Google Cloudでデータ分析基盤を構築する際も、業務システム側のOLTPデータをそのままBigQueryに複製することは避けましょう。分析用途に合わせてスキーマを設計し直す工程が必要になります。
正規化の知識は今も必要とされている?
正規化・非正規化の知識は独学の趣味レベルではなく、実務者に今も求められる技能です。独立行政法人情報処理推進機構(IPA)が実施する国家試験「データベーススペシャリスト試験」のシラバスでも、論理データモデル作成の技能要求として「正規化を実践する能力」が明記されています(データベーススペシャリスト試験(レベル4)シラバス Ver.4.1)。
データベース正規化と機械学習の「正規化」は何が違う?
データベース正規化と機械学習の「正規化」は、同じ言葉でも指している対象がまったく異なります。
| 種類 | 意味 | 対象 |
|---|---|---|
| データベース正規化 | テーブル設計を整理し、重複・矛盾を排除すること | DB設計 |
| 特徴量スケーリング | 数値の範囲を揃えること(例:0〜1に変換) | 機械学習の前処理 |
この記事で扱っているのは「データベース正規化」ですが、機械学習の文脈では「正規化」がMin-Max正規化や標準化(Z-score)などの特徴量スケーリングを指すことがあります。両者はまったく異なる概念のため注意が必要です。詳しくはディープラーニング vs 機械学習:違いと使い分けを徹底解説でも関連する前処理の考え方を解説しています。
データベース正規化は、テーブル内の不要なデータ重複を減らし、更新時の矛盾を防ぐことで、データを一貫して管理しやすくする設計手法です。こうした適切なデータ管理は、機械学習に利用するデータを整備するうえでも重要です。
ただし、同じ顧客が異なるIDで重複登録されているケースや、住所の表記が統一されていないケースは、データベース正規化だけでは解決できません。これらには、名寄せや重複除去、表記統一などのデータクレンジングが必要です。
機械学習では、データベースの構造だけでなく、欠損値や重複、表記ゆれ、外れ値などにも対処し、学習に使用するデータの品質を整えることが重要です。
SQL・Pandasで正規化を実装するには?
正規化の実装は、SQLのCREATE TABLEとPandasのdrop_duplicates()を使えばそれほど難しくありません。自分でコードを書く機会がない方は、以下は「実際にはこう実装される」という参考として眺めるだけでも問題ありません。
SQL(MySQL・PostgreSQL など)
正規化したテーブル設計を実装する最も一般的な方法です。CREATE TABLE 文で外部キーを設定し、JOIN でテーブルを結合します。
-- 住所テーブル(先に作成)
CREATE TABLE addresses (
  address_id INT PRIMARY KEY,
  prefecture VARCHAR(50),
  city VARCHAR(100)
);

-- 顧客テーブル
CREATE TABLE customers (
  customer_id INT PRIMARY KEY,
  name VARCHAR(100),
  phone VARCHAR(20),
  address_id INT,
  FOREIGN KEY (address_id) REFERENCES addresses(address_id)
);
Python(Pandas)
既存のCSVやExcelデータを正規化された形に変換したい場合は、PandasのDataFrameを使って列の分割や重複除去を行えます。
import pandas as pd

# 元データ(顧客・住所・購入が1つのテーブルに混在)
df = pd.read_csv("customers_raw.csv")

# 住所テーブルを切り出し(重複除去してaddress_idを付与)
addresses = (
    df[["address"]]
    .drop_duplicates()
    .reset_index(drop=True)
    .rename_axis("address_id")
    .reset_index()
)

# 顧客テーブルを作成(住所はaddress_idで参照)
customers = (
    df.merge(addresses, on="address")[["customer_id", "name", "phone", "address_id"]]
    .drop_duplicates(subset="customer_id")
)

# 購入テーブルを分離
purchases = df[["customer_id", "product"]].reset_index(names="purchase_id")
drop_duplicates() で重複を排除し、参照用IDを付与して別DataFrameに分離することで、3NFに近い形へ再構成できます。
まとめ
データベースの正規化とは、データを長期的に安全・正確に管理するための基本設計です。本記事のポイントをまとめます。
- 正規化とは・目的:データの重複や矛盾を排除するためにテーブル構造を段階的に整理する設計手法で、データの整合性・参照しやすさ・保守性を高める目的があります
- 正規化の手順と正規形の種類:Step 1〜5の手順で1NF→2NF→3NFの順に適用します。1NFは各列がスカラ値になっている状態、2NFは非キー属性が主キーに完全従属している状態、3NFは非キー属性が他の非キー属性に推移従属していない状態です
- メリット・デメリット:データの一貫性を保てる一方、JOIN増加でクエリが複雑になります。これを解消する手段が反正規化(非正規化)です
- 実務での使い分け:OLTPでは正規化が基本、BigQueryなどの分析基盤では非正規化が推奨されます
- 機械学習の「正規化」との違い:機械学習の「正規化」は特徴量スケーリングを指し、データベース正規化とは別の概念です
- SQL・Pandasでの実装:
CREATE TABLE・JOINやPandasのdrop_duplicates()で正規化を実装できます
正規化の基本を押さえたうえで、業務システムと分析基盤それぞれに合ったテーブル設計を選べるようになれば、データ活用の土台が安定します。まずは手元のテーブル構造を見直す、あるいはエンジニアと設計方針を話し合うところから始めてみましょう。
出典一覧
- 「What is database normalization?」 — Google Cloud
- 「Use nested and repeated fields」(BigQuery公式ドキュメント)
- 「データウェアハウスからBigQueryへの移行:スキーマとデータ転送の概要」(2026-04-04更新)
- 「A Relational Model of Data for Large Shared Data Banks」 — E.F. Codd、Communications of the ACM(1970-06)
- 「データベーススペシャリスト試験(レベル4)シラバス Ver.4.1」(Ver.4.1)
執筆者:えだまめ
Elcamyでバックオフィスとブログ執筆を担当。AI未経験の状態からAI活用を学び、Claude CodeをはじめとするAIエージェントの実務活用法を発信している。
更新情報はElcamy公式Xでも発信中。

