
はじめに
AI・機械学習の分野では、モデルが数億から数十億のパラメータを持つほど大規模化しています。ただし、こうしたモデルは計算リソースを大量に消費するため、実際のアプリケーションで動かす際には効率性の確保が課題になります。この課題に対応する技術が、「Distillation(蒸留)」です。
本記事では、Distillationの基本概念から具体的な手法、応用例に加え、2026年に主要フロンティアモデルの標準手法となったオンポリシー蒸留や、蒸留をめぐる政策・法的な論点まで、最新動向を交えて解説していきます。
- 蒸留(Distillation)は、教師モデルの知識を軽量な生徒モデルへ引き継がせ、性能をできるだけ維持しながら計算コストの削減を目指す技術
- 代表的な実例はDistilBERT(BERTの60%サイズでGLUE 97%の性能)やDeepSeek-R1の推論蒸留(32BモデルでAIME 2024 pass@1 72.6%)
- 2026年、「オンポリシー蒸留(OPD)」がQwen3・DeepSeek-V4など主要フロンティアモデルの標準的な訓練手法として定着
- 蒸留には性能劣化やデータ要件などの課題があるが近年は改善が進行中。蒸留をめぐる政策・法的な論点も浮上
1. Distillationとは?
Distillationとはどんな技術?
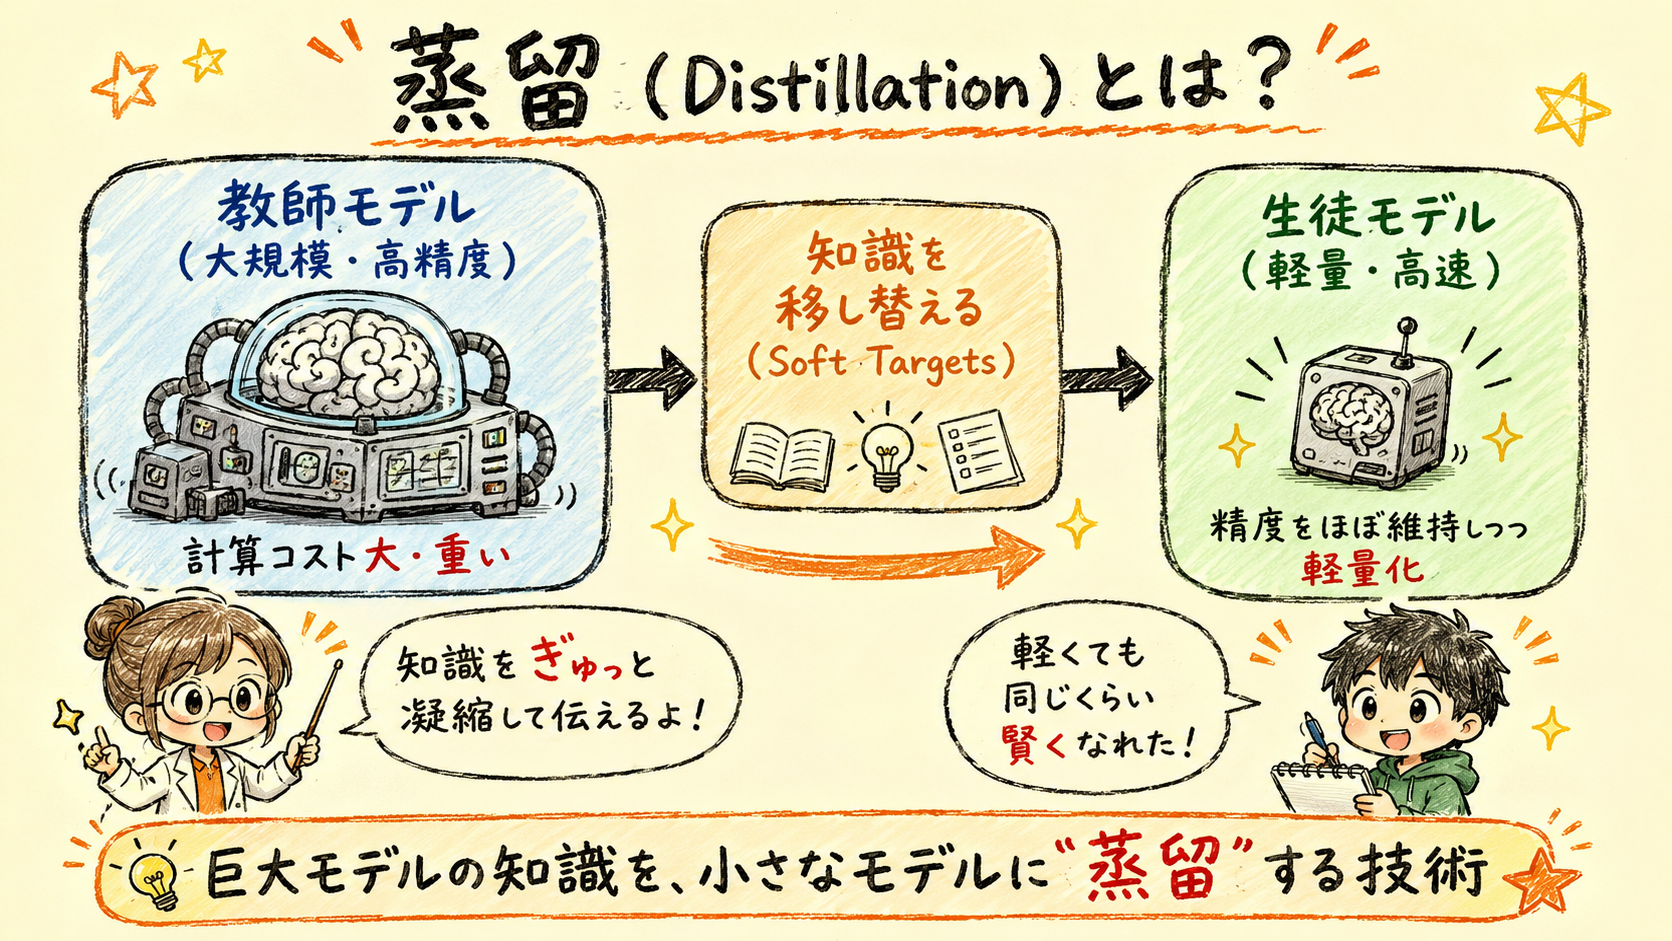
Distillation(蒸留)は、高性能な「教師モデル」の知識や能力を、より小さな「生徒モデル」に引き継がせる技術です。
教師モデルの出力や振る舞いを生徒モデルに学習させることで、性能をできるだけ維持しながらモデルを小型化し、推論時の計算コストや必要なリソースを削減することを目指します(Xu et al.)。
こうした特徴から、モバイルデバイスや組み込みシステムなど、計算リソースが限られた環境でのモデル活用にも有効な手法として研究されています。
Distillationはいつ生まれた技術?
Distillationの概念は、機械学習のパイオニアであるGeoffrey Hintonらが2015年に“Knowledge Distillation”として広めましたが(Hinton et al., 2015)、アイデア自体はBucila et al.(2006)のModel Compressionに遡ります(Bucila et al., 2006)。
Hintonらの研究は、Deep Neural Networks(DNN)が保持する膨大な知識を、いかにして効率的に縮小し、より小型のデバイスでも運用可能にするかという課題に対する解決策として、この技術を紹介しました。この研究は、大規模なモデルを効果的に圧縮し、実用的な範囲で利用できるようにする技術の基盤を築きました。
Distillationの目的と利点は?
Distillation技術の主な目的は、モデルの圧縮と効率化です。以下に、具体的な利点を挙げます。
| 利点 | 説明 |
|---|---|
| モデルサイズの削減 | モデルを圧縮することで、ストレージやメモリの使用量が削減される |
| 推論速度の向上 | 圧縮されたモデルは、推論の際に必要な計算リソースが少なくなるため、処理速度が向上 |
| メモリ使用量の削減 | 小型化されたモデルは、実行時のメモリ消費量も削減され、モバイルデバイスなどのリソースが限られた環境でも利用可能になる |
| 適用の容易さ | 小型の生徒モデルは、IoTデバイスやエッジデバイスなど、幅広い応用に適用しやすくなる |
2. Distillationはどんな仕組みで動く?
モデル圧縮はなぜ必要?
現在の機械学習モデルは、精度を追求するあまり、非常に複雑かつ大規模になりがちです。例えば、自然言語処理や画像認識の分野では、巨大なデータセットに対応するために、数億から数十億のパラメータを持つモデルが利用されています。
しかし、これらのモデルをスマートフォンやIoTデバイスのようなリソースが限られた環境で運用するのは難しく、ここでモデル圧縮の必要性が浮かび上がります。
教師モデルと生徒モデルの関係は?
Distillationでは、まず高性能な教師モデルを訓練します。この教師モデルが生成する出力(これを「Soft Targets」と呼びます)をもとに、生徒モデルを訓練します。生徒モデルは、教師モデルと比べて軽量で、推論時の効率性が高いです。
Soft Targetsは、教師モデルの出力に含まれるクラス間の確率分布を保持し、生徒モデルがその情報を学習することで、小型化による性能低下を抑えながら、教師モデルの知識を効率的に引き継ぐことを目指します。
ロス関数と温度パラメータの役割は?
Distillationプロセスでは、ロス関数(教師モデルと生徒モデルの出力のズレを数値化する関数)と温度パラメータが重要な役割を果たします。ロス関数は、教師モデルと生徒モデルの出力の差を最小化するように設計されており、これにより生徒モデルが教師モデルの知識を正確に学習します。
温度パラメータとは、教師モデルの出力する確率分布の「柔らかさ」を調整する値のことです。高い温度設定は出力の確率分布を均一化し、生徒モデルがより微細な情報を学習しやすくなります。
3. Distillationにはどんな手法がある?
Soft Targetsとは?
Distillationの中心的な手法の一つに、「Soft Targets」の利用があります。Soft Targetsは、教師モデルの出力層から得られる確率分布のことで、正解クラスのみを1、それ以外を0で表す通常のone-hotラベル(Hard Targets)とは異なり、各クラスに対する確率が滑らかに分布しています。
例えば、ある画像が「猫」として分類される確率が0.9で、「犬」として分類される確率が0.1である場合、Soft Targetsはこの情報を含みます。
このSoft Targetsを用いて生徒モデルを訓練することで、より豊富な情報を学習させることが可能です。Soft Targetsはクラス間の相対的な確率を示すため、生徒モデルが異なるクラス間の微妙な違いを学習するのに役立ちます。
Distillationの手順は?
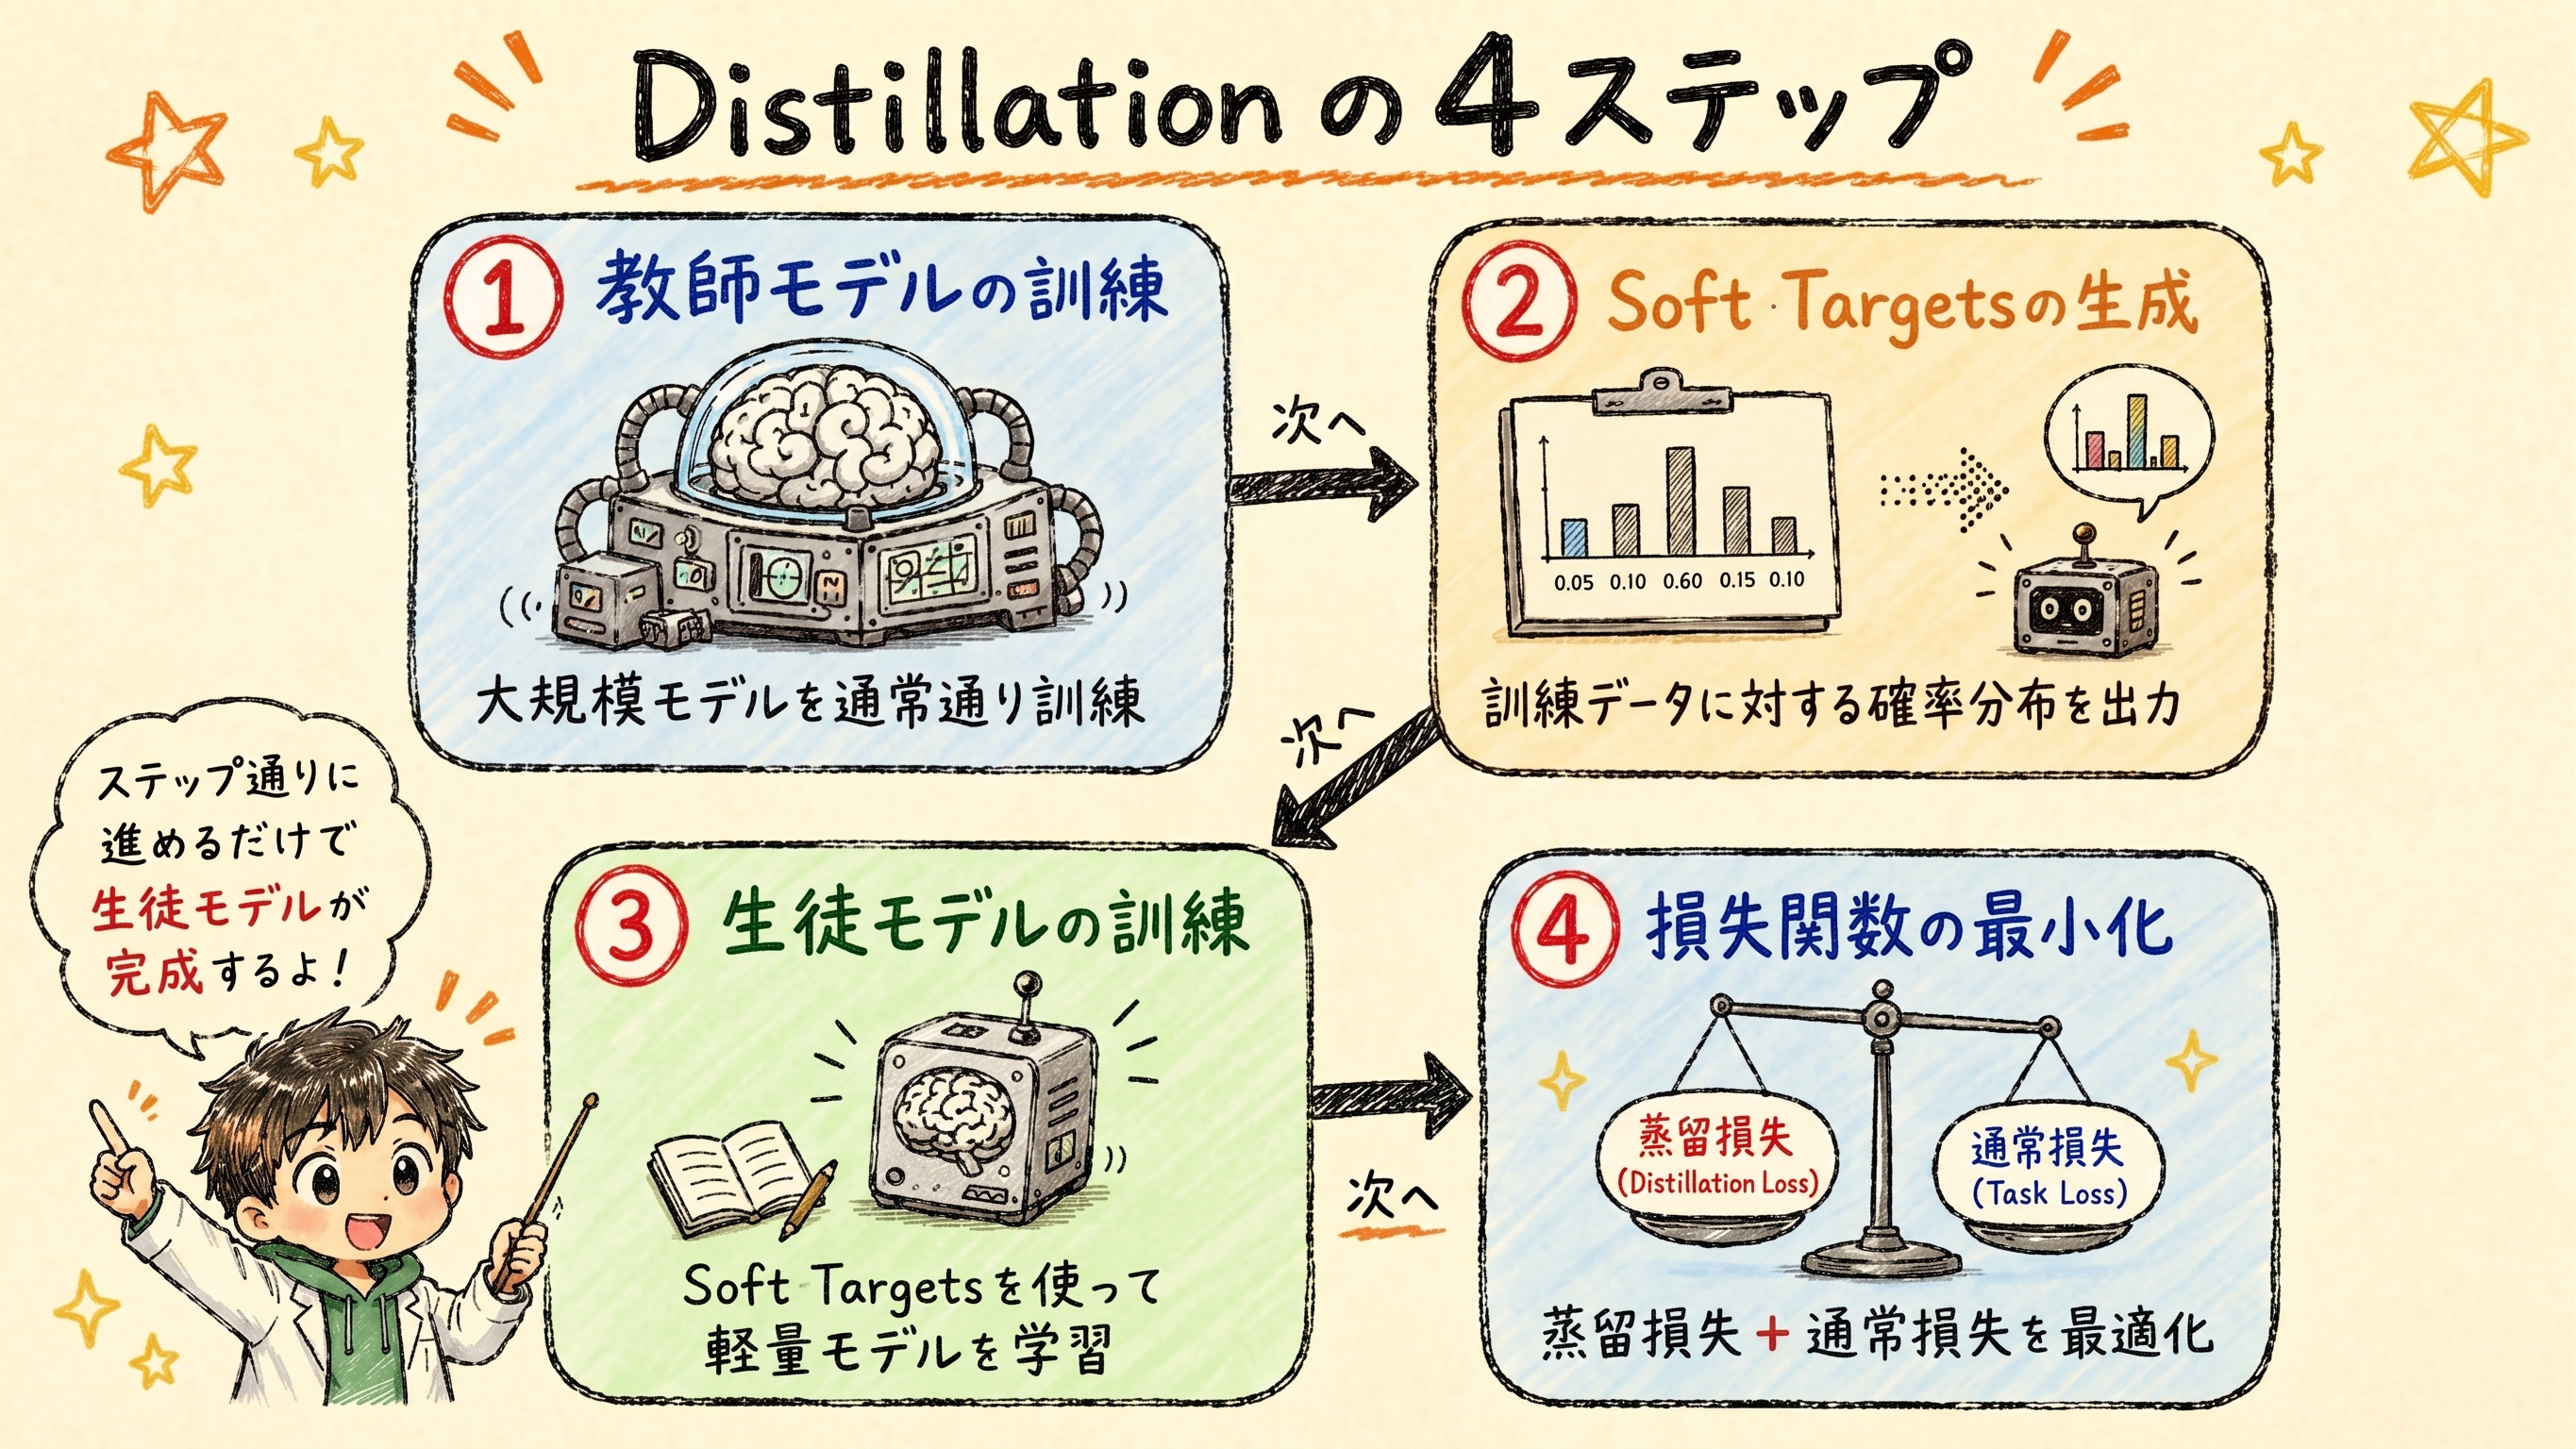
Distillationのアルゴリズムは以下のように進行します。
- 教師モデルの訓練
まず、大規模で高性能な教師モデルを通常の方法で訓練します。このモデルは、高精度な予測を行うために設計されています。 - Soft Targetsの生成
訓練済みの教師モデルを用いて、訓練データセットの各入力に対してSoft Targetsを生成します。 - 生徒モデルの訓練
生徒モデルは、教師モデルが生成したSoft Targetsを使って学習します。この際、通常のクロスエントロピー損失(予測確率と正解ラベルとのズレを数値化する一般的な損失関数)に加えて、蒸留損失(教師モデルのSoft Targetsと生徒モデルの予測分布とのズレを数値化する損失関数)を組み合わせて使用します。 - 損失関数の最小化
最終的に、蒸留損失と通常の損失の和を最小化するように、生徒モデルのパラメータを最適化します。
どんな分野で効果を発揮している?
Distillationは多くの分野で効果を発揮しています。具体的には、次のような分野が挙げられます。
- 画像認識
大規模な畳み込みニューラルネットワーク(CNN)モデルから小型のCNNモデルへの知識蒸留により、精度を維持しつつ、推論速度を大幅に向上させることができます。 - 自然言語処理
BERTなどの大規模な言語モデルから、小型のTransformerモデルへの蒸留により、リアルタイムアプリケーションでの使用が可能になります。 - 音声認識
高性能な音声認識モデルから、軽量なモデルへの知識蒸留により、モバイルデバイスでのリアルタイム音声認識が実現します。
こうした応用例は、実際のプロジェクトでも成果を上げています。
4. Distillationはどこで使われている?
実際のプロジェクトでの活用例は?
Distillation技術は、さまざまな実プロジェクトにおいて成功を収めています。例えば、GoogleのBERTモデルは、非常に高精度な自然言語処理タスクを実行することで知られていますが、そのサイズと計算コストが非常に大きいです。
これに対して、Distillationを用いて開発された「DistilBERT」は、BERTの60%のサイズでありながら、ほぼ同等の性能(自然言語理解タスクの標準的な評価指標群であるGLUEベンチマークで97%、推論速度は60%高速)を発揮します(Sanh et al.)。これにより、BERTの持つ強力な機能をモバイルデバイスや組み込みシステムで活用することが可能になりました。
モバイルデバイスや組み込みシステムでどう使われている?
Distillationは、特にリソースが限られた環境での利用が期待されています。
具体例:
- スマートフォンのアシスタント機能
-
音声認識や自然言語処理を行うためのモデルは、大規模なものが多いですが、Distillationによりこれらのモデルを小型化し、スマートフォン上でのリアルタイム処理が可能になります。
企業・研究 蒸留の内容 成果 Google スマートスピーカーやオンデバイス向けのストリーミングASR(自動音声認識)で、非ストリーミングモデルを教師とした蒸留を実施 精度を維持しながら高速化を実現(Google Research) Apple 誤起動を防ぐ「誤起動低減(False-Trigger-Mitigation)」技術で、ASRモデルから音響モデルへ知識蒸留を適用 精度(EER)を66%向上(Apple Machine Learning Research) RNN-Transducer型ASRの研究 RNN-Transducer型のASRモデルを対象にした蒸留手法 LibriSpeechデータセットで相対WER(単語誤り率)を4.8%削減(arXiv:2011.06110)
-
- IoTデバイス
- スマートホームデバイスやウェアラブルデバイスなどのIoTデバイスでも、Distillationは重要な役割を果たします。これらのデバイスは計算リソースやバッテリー容量が限られているため、軽量で効率的なモデルが求められます。Distillationを用いることで、これらの制約を克服し、より高度な機能を提供できるようになります。
大規模モデルは現場でどう活用されている?
企業や研究機関で使用される大規模モデルも、Distillationにより現場での適用が容易になります。実際に、次のような分野での導入が進んでいます。
適用例:
- 金融業界
- 大規模なリスク評価モデルや予測モデルは、通常、データセンターで実行されますが、リアルタイムの意思決定には小型化されたモデルが必要です。Distillationを用いることで、これらのモデルを小型化し、リアルタイムのリスク評価や予測が可能になります。
- 医療分野
- 医療画像の診断や患者データの解析には、通常、高性能なモデルが必要です。Distillationを用いて、これらのモデルを軽量化し、現場の医療機器でのリアルタイム診断を支援します。
- AIインフラ・半導体業界
-
GPU開発で知られる半導体大手のNVIDIAは、既存の大規模モデルを構造的プルーニングと知識蒸留の組み合わせで圧縮する「Minitron」(NVIDIAが手がける圧縮モデル手法の名称)を展開しています。
項目 内容 手法 構造的プルーニングと知識蒸留を組み合わせた「Minitron」 MMLUスコア 同規模のモデルをゼロから学習する場合と比べて最大16%向上 学習トークン数 最大40分の1まで削減 適用事例 Llama-3.1 8Bから「Llama-3.1-Minitron 4B」を作成 出典:NVIDIA公式ブログ
-
金融・医療・半導体という異なる業界に共通するのは、大規模モデルの性能を維持したまま、現場で動かせるサイズまで圧縮するというニーズです。
5. Distillationにはどんな課題がある?
現在、どんな課題がある?
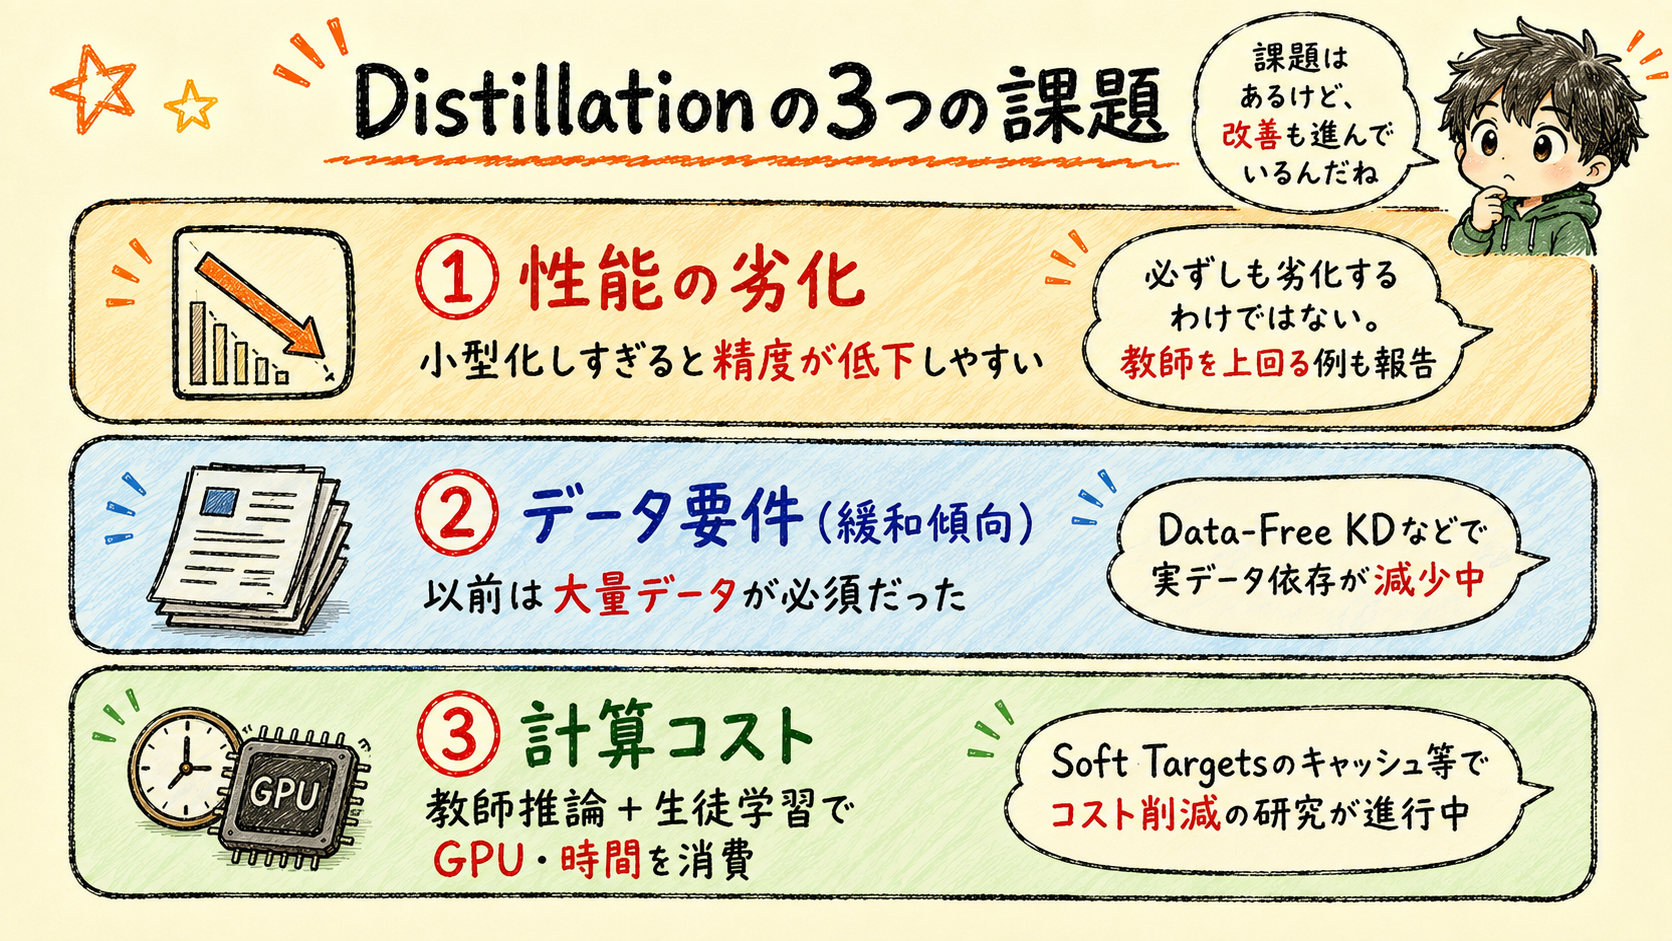
Distillation技術は多くの利点を持っていますが、いくつかの課題も存在します。
| 課題 | 詳細 | 重要なニュアンス |
|---|---|---|
| 性能の劣化 | 小型化しすぎると精度が低下しやすい。 | 必ずしも精度が低下するわけではありません —近年は Self-/Iterative Distillation や「生徒を教師よりやや大きくする」設定で、教師を上回る例も報告されています (例:Noisy Student など)。 |
| データ要件(緩和傾向) | 以前は大量・多様なラベル付きデータが必須とされた。 | 実データ依存は大幅減 —自己蒸留や Data-Free KD(生成モデル・勾配ヒント)により、擬似データのみでも高精度を達成可能。 ただし、タスクが特殊・ドメインがニッチなほど少量の実データ追加が依然有利です。 |
| 計算コスト | 教師推論+生徒学習で GPU/時間を消費。 | キャッシュ済み Soft Targets や動的サンプリングでコスト削減する研究が進行中。 |
蒸留をめぐる政策・法的論点はどう顕在化している?(2026年)
2026年に入り、蒸留は技術的な是非にとどまらず、政策・契約上の論点としても表面化しています。2026年2月12日、OpenAIは米下院の対中国戦略競争特別委員会に宛てた公式文書を公表し、DeepSeekの従業員がOpenAIのAPIアクセス制限を回避してAPI出力をプログラム的に収集し、自社モデルの蒸留に利用した可能性があると主張しました(OpenAI)。
この一件を背景に、主要なAIプロバイダーの間では、API利用規約で「自社モデルの出力を用いた競合モデルの学習(事実上の蒸留)」を明示的に禁止する動きが広がりつつあるとされています。蒸留自体は今後も有効な技術手法であり続ける一方、提供元の利用規約に抵触しないかを事前に確認することが、実務上の重要な留意点になりつつあります。
Distillationの将来性は?
Distillation技術の未来には、多くの可能性が広がっています。
- 自動化と最適化
Distillationプロセスの自動化と最適化が進むことで、より簡単に効率的な生徒モデルを生成できるようになるでしょう。AutoML(自動機械学習)の技術と組み合わせることで、最適なDistillation戦略を自動的に選択するシステムが開発される可能性があります。 - ハイブリッドモデルの開発
複数の教師モデルからの知識を統合し、生徒モデルに移行する「ハイブリッドDistillation」技術が注目されています。これにより、複数の異なるタスクやドメインの知識を一つの生徒モデルに集約することが可能になります。 - オンラインDistillation
従来のDistillationはオフラインで行われることが一般的ですが、オンラインDistillationの研究も進んでいます。これにより、モデルがリアルタイムで新しいデータから学習し続けることが可能になり、適応性が向上します。
最新の研究ではどんな動きがある?
Distillationの分野では、最新の研究が続々と発表されています。例えば、「自己蒸留(self-distillation)」という手法では、一つのモデルが自身の出力を用いて再度訓練されることで、モデルの精度を向上させる技術が提案されています(Xie et al.)。
また、「クロスモーダル蒸留(cross-modal distillation)」では、画像とテキストなど異なるモダリティ間での知識の移行が試みられています(arXiv:2412.01282)。これにより、例えば、画像認識モデルの知識を自然言語処理モデルに転用するなどの可能性が広がっています。
さらに近年では、「教師を上回る(teacher-overpassing)」という現象への関心が高まっており、線形回帰のような理論的に単純な設定でも、繰り返し自己蒸留を行うことで生徒モデルが教師モデルを上回りうることが理論的に示されています(arXiv:2407.04600)。
| 手法 | 説明 |
|---|---|
| 自己蒸留・データフリー蒸留 | モデル自身の出力や生成データを使って再学習し、実データなしで精度向上を目指す手法 大量データ依存を大きく緩和するアプローチとして注目されています |
| クロスモーダル蒸留(研究段階) | 画像モデルからテキストモデルへの知識転移など、異なるモダリティ間の蒸留を試みる研究が活発化 CLIPやLLaVA系の手法が代表例ですが、現在はまだ研究やPoC段階が中心です 産業応用に向けては、データ整合性や評価指標の標準化が今後の課題とされています |
| 教師超えモデル | Noisy Studentなど画像認識分野での報告に加え、線形回帰のような理論的に単純な設定でも、自己蒸留を繰り返すことで誤差が大きく減少することが理論的に示されています |
6. 2025〜2026年、LLM蒸留はどう進化した?
前章で触れた「教師超えモデル」といった研究トレンドは、2025年以降、大規模言語モデル(LLM)の分野で一気に現実のものとなりました。特に2025年以降、「推論能力そのものを蒸留する」という新しいアプローチが広まり、技術の意味合いが大きく変化しています。
さらに2026年には、蒸留の手法自体が「オフポリシー」から「オンポリシー」へと進化し、主要フロンティアモデルの標準的な訓練プロセスに組み込まれるようになりました。
- オフポリシー蒸留:教師モデルの出力をそのまま模倣する方式
- オンポリシー蒸留:生徒モデル自身の出力に教師モデルがフィードバックする方式
DeepSeek-R1はどのように「推論蒸留」を示した?
2025年1月、中国のDeepSeekが公開した DeepSeek-R1 は、蒸留の歴史における重要な事例として広く注目されました。DeepSeek-R1は、強化学習(RL)によって獲得した高度な「連鎖思考(Chain-of-Thought)」推論能力を、1.5B〜70Bパラメータの小型モデルへ蒸留することに成功しました(DeepSeek-AI)。
| 蒸留モデル | ベース | AIME 2024スコア(pass@1) |
|---|---|---|
| DeepSeek-R1-Distill-Qwen-7B | Qwen2.5-Math-7B | 55.5% |
| DeepSeek-R1-Distill-Qwen-32B | Qwen2.5-32B | 72.6% |
| (参考)OpenAI o1-mini | - | 63.6% |
7Bという小型モデルが数学推論ベンチマークで高い精度を示し、32BモデルはAIME 2024(pass@1、1回の生成で正解した割合)で72.6%を記録し、OpenAI o1-miniの63.6%を上回る水準に達したことが、業界で広く注目されました。
オンポリシー蒸留(On-Policy Distillation)はなぜ2026年の標準手法になった?
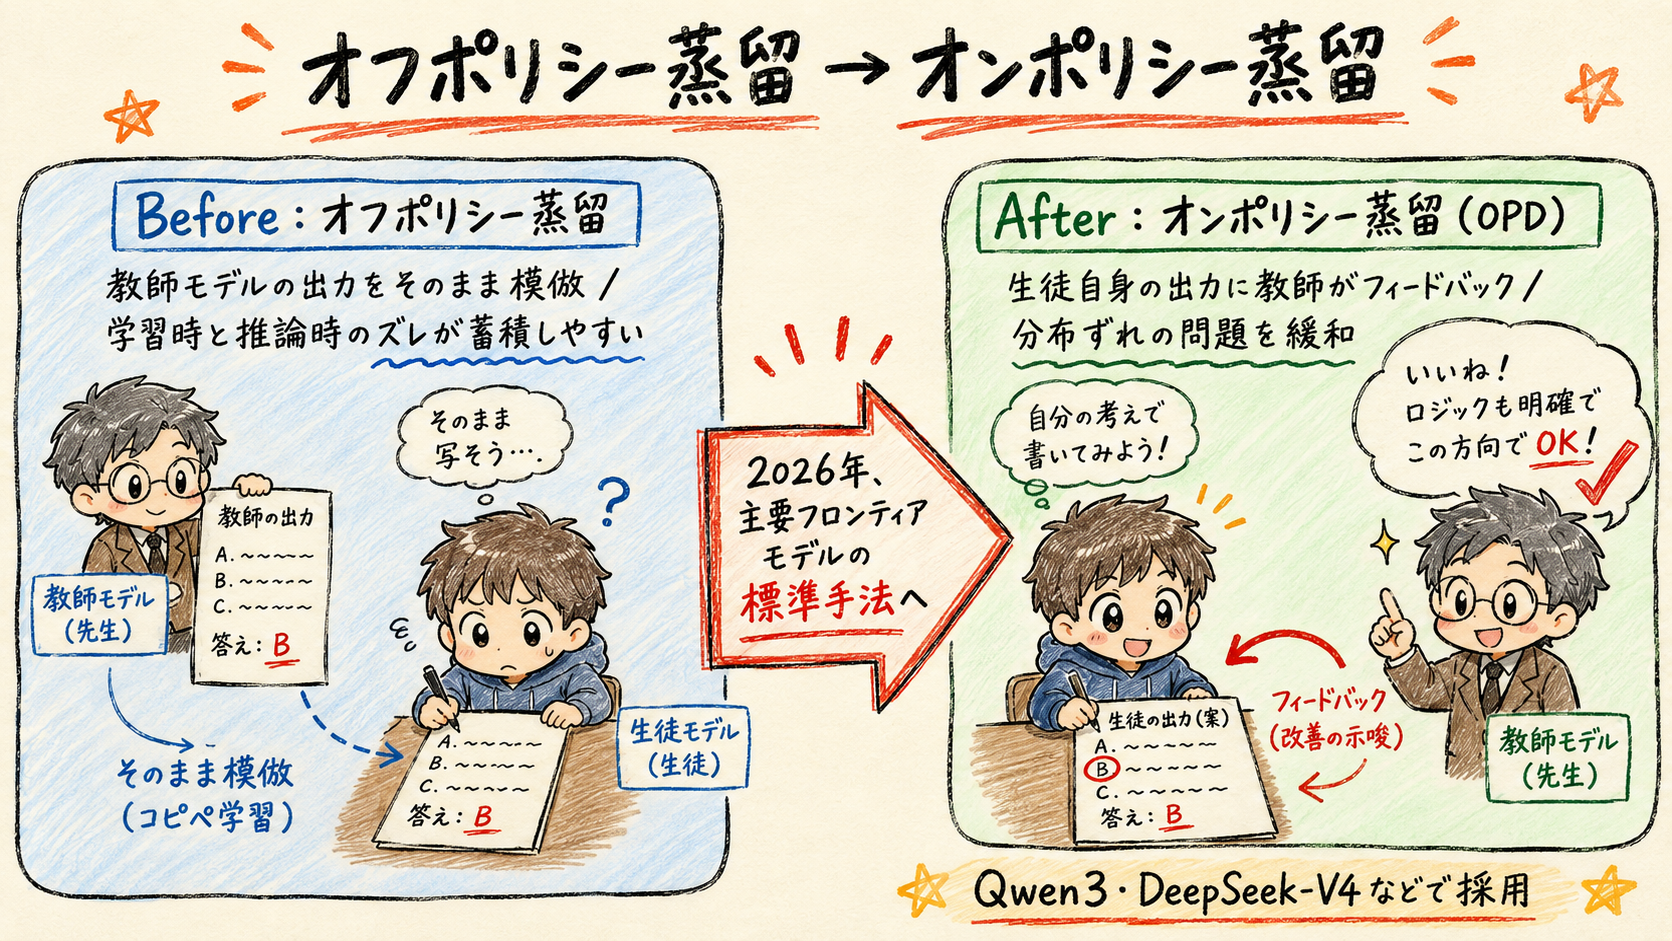
2026年に入り、蒸留手法の主流は「教師モデルの出力をそのまま模倣するオフポリシー蒸留」から、生徒モデル自身が生成した出力に対して教師モデルがフィードバックを与えるオンポリシー蒸留(On-Policy Distillation, OPD)へと移行しています。これは、学習時と推論時で系列の生成方式が異なることに起因する誤差が、系列が長くなるほど積み重なっていく「分布ずれ」の問題を緩和する手法として体系化されたものです。
なお、前章の「未来の展望」で触れた、モデルがリアルタイムで新しいデータから学習し続ける「オンラインDistillation」とは異なる概念です。
2026年時点で、OPDは複数の主要フロンティアモデルの技術レポートにおいて、標準的な訓練手法として採用が確認されています。
| モデル | 蒸留手法の概要 |
|---|---|
| Qwen3(0.6B〜14B) | 235B/32B規模のフラッグシップモデルを教師としたオフポリシー蒸留とオンポリシー蒸留を併用し、強化学習単独と比べて約10分の1のGPU計算時間で同等以上の性能を達成(Qwen Team) |
| Gemma 3 | 事前学習では全モデルサイズで知識蒸留を採用し、事後学習でも命令調整済みの大型教師モデルからの蒸留を実施(Google DeepMind) |
| Gemma 4 | 技術レポートでは「Gemma 3と類似のポストトレーニング手法」を採用したと説明されており、Gemma 3譲りの蒸留を引き継いでいるとみられます(Google DeepMind) |
| DeepSeek-V4 | 数学・コーディング・エージェント・指示追従など、分野別に育成した複数の専門家モデルを1つの統合モデルへ集約するオンポリシー蒸留(OPD)を採用(DeepSeek-AI) |
RLVRと蒸留の融合とは?
DeepSeek-R1の成功を受け、2025〜2026年にかけて RLVR(Reinforcement Learning with Verifiable Rewards) と蒸留を組み合わせた研究が急増しています。
RLVRは、答えの正誤など「検証可能な報酬」を使って強化学習を行う手法です。これと自己蒸留を組み合わせた Self-Distilled RLVR では、同一モデルが教師と生徒の両方を兼ねるという特徴があります。
RLVRの疎な報酬信号と自己蒸留のトークンレベルの細かいフィードバックを組み合わせることで、学習の安定性と到達できる性能の上限を高める効果が報告されています(Self-Distilled RLVR)。
AIエージェント向けの蒸留はどこまで進んでいる?
2026年に入り、蒸留の応用は AIエージェント の領域にも広がっています。例えば、スミッシング(SMS詐欺)検知のような特定タスクにおいて、複雑な判断を行う大規模エージェントの行動パターンを軽量な小型モデルへ転移する実証実験が報告されており(arXiv:2602.10869)、今後は業務自動化やエッジデバイスでのエージェント実行など、同様の応用が広がる可能性があります。
オンデバイスAIでの蒸留活用は?
スマートフォンやPCのローカルでAIを動かす「オンデバイスAI」においても、蒸留は欠かせない技術となっています。例えばAppleは、iPhone上で動作する「AFM-on-device」モデルの事前学習において、サーバー向けの大型モデル「AFM-server」を教師とした蒸留損失を採用しています。
教師モデルの予測確率と正解ラベルを組み合わせた学習を行うことで、MMLUで約5ポイント、GSM8K(算数の文章題で数学的推論力を測るベンチマーク)で約3ポイントの性能向上を確認したと公式論文で報告しています(Apple)。
まとめ:Distillationは軽量AI活用の中核技術
Distillationは、大規模な教師モデルから小型の生徒モデルへ知識を効果的に移行することで、効率的で実用的なモデルを生成する技術です。
- 大規模な教師モデルの知識を軽量な生徒モデルへ移し替え、精度を維持しながら計算コストを削減する技術(DistilBERT・NVIDIA Minitronなどが実例)
- 教師モデルの訓練→Soft Targetsの生成→生徒モデルの訓練→損失関数の最小化という手順で進み、画像・自然言語・音声など幅広い分野で活用
- 性能劣化やデータ要件、計算コストといった課題は残るが、自己蒸留やData-Free KDなどの手法により近年は改善が進行中
- 2025〜2026年にはDeepSeek-R1の推論蒸留やオンポリシー蒸留(OPD)がQwen3・DeepSeek-V4などで標準化され、蒸留をめぐる政策・法的論点も顕在化
Distillationをはじめとする最新のAI技術にご興味がある方、あるいは具体的なプロジェクトへの導入をご検討中の方は、ぜひ株式会社Elcamyにご相談ください。「何から始めるべきか」といった段階から、確かな技術力と専門知識で貴社のビジネス課題の解決をサポートいたします。
出典一覧
- 「A Survey on Knowledge Distillation of Large Language Models」 — Xu et al.(2024-02-20)
- 「Distilling the Knowledge in a Neural Network」 — Hinton, Vinyals, Dean(Google、2015-03-09)
- 「Model Compression」 — Bucila, Caruana, Niculescu-Mizil(Cornell University、2006)
- 「DistilBERT, a distilled version of BERT: smaller, faster, cheaper and lighter」 — Sanh et al.(Hugging Face、2019-10-02)
- Apple Machine Learning Research — Apple
- Google Research — Google
- arXiv:2011.06110 — arXiv
- 「How to Prune and Distill Llama-3.1 8B to an NVIDIA Llama-3.1-Minitron 4B Model」 — NVIDIA
- 「Self-training with Noisy Student improves ImageNet classification」 — Xie et al.(2019)
- 「Self-Distillation from the Last Mini-Batch for Consistency Regularization」 — arXiv(2022)
- 「Dreaming to Distill: Data-Free Knowledge Transfer via DeepInversion」 — Yin et al.(CVPR 2020)
- 「Small-Scale Data-Free Knowledge Distillation」 — Liu et al.(CVPR 2024)
- 「A survey on knowledge distillation: Recent advancements」 — Moslemi et al.(Machine Learning with Applications、2024)
- 「Align-KD: Distilling Cross-Modal Alignment Knowledge for Mobile Vision-Language Model Enhancement」 — arXiv
- 「CLIP-KD: An Empirical Study of CLIP Model Distillation」 — Yang et al.(CVPR 2024)
- 「LLaVA-MoD: Making LLaVA Tiny via MoE Knowledge Distillation」 — arXiv
- 「C2KD: Bridging the Modality Gap for Cross-Modal Knowledge Distillation」 — Huo et al.(CVPR 2024)
- 「Understanding the Gains from Repeated Self-Distillation」 — arXiv
- 「DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning」 — DeepSeek-AI(2025-01-22)
- DeepSeek-R1-Distill-Qwen-7B モデルカード — Hugging Face
- 「Qwen3 Technical Report」 — Qwen Team(Alibaba、2025-05-15)
- 「Gemma 3 Technical Report」 — Google DeepMind(2025-03-25)
- 「Gemma 4 Technical Report」(2026-07)
- 「DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence」 — DeepSeek-AI
- 「Self-Distilled RLVR」 — Hugging Face
- 「Agentic Knowledge Distillation: Autonomous Training of Small Language Models for SMS Threat Detection」 — arXiv
- 「Apple Intelligence Foundation Language Models」 — Apple
- 「Letter to the House Select Committee on the Strategic Competition between the United States and the Chinese Communist Party on Updated Stakes for American-Led, Democratic AI」 — OpenAI(2026-02-12)
執筆者:えだまめ
Elcamyでバックオフィスとブログ執筆を担当。AI未経験の状態からAI活用を学び、Claude CodeをはじめとするAIエージェントの実務活用法を発信している。
更新情報はElcamy公式Xでも発信中。